GenAI experience
Session à venir
12/11/2026 au 13/11/2026
Durée
2 jours

Quand on parle d’IA, et de LLM en particulier, on entend souvent la même explication : ce ne serait pas vraiment de l’intelligence, juste une machine très douée pour calculer des probabilités sur des mots. Et il faut reconnaître que cette explication a le mérite d’être rassurante.
Sauf que quand on creuse un peu, les choses sont moins simples.
Ce qui est certain, c’est que l’IA ne fonctionne pas de la même manière que nous, mais pour autant, elle pourrait bien fonctionner comme une forme d’intelligence, différente de la nôtre, mais une intelligence tout de même.
Le débat reste ouvert, mais il mérite qu’on s’y intéresse.
Et pour s’y intéresser, encore faut-il comprendre ce qui se passe sous le capot.
Quand j’étais étudiant, on nous a parlé de la RAM, des cartes mères, des processeurs, du pipeline, de la heap, de la stack, pas parce qu’on en avait besoin au quotidien, mais parce que cette vision des mécanismes bas niveau nous permettait de mieux raisonner sur les programmes qu’on construisait.
Avec les LLM, je pense que c’est pareil, pour évoluer avec cette technologie, il faut qu’on ait une vision à peu près claire de ce qui se passe à l’intérieur.
C’est ce que je vous propose avec une série d’articles qui commence par celui-ci : un exercice de vulgarisation très élémentaire, pour toucher du doigt ce qui se passe à l’intérieur de ces modèles.
Des liens en notes de bas de page sont également là pour ceux qui souhaitent aller plus loin…
Commençons !
Voici une phrase : Le chat que la souris que le chien poursuit regarde dort.
À première vue, vous en pensez quoi ? Cette phrase semble incorrecte, elle ne veut rien dire, il y a des mots en trop, des verbes en trop ?
Et pourtant cette phrase est correcte, essayons d’ajouter un peu de ponctuation, car c’est peut-être bien ce qu’il manque.
Le chat, que la souris que le chien poursuit regarde, dort.
Mmm… Ouais, ok, « le chat dort » cela semble désormais clair. Mais ce qui se passe entre les deux virgules reste encore difficile à saisir.
Ajoutons deux autres virgules.
Le chat, que la souris, que le chien poursuit, regarde, dort.
Bon d’accord, c’est pas super comme formulation je vous l’accorde, et je ne suis pas forcément sûr que mon placement de virgules soit parfaitement académique mais pourtant là on comprend le sens : un chien poursuit une souris, qui elle-même regarde un chat, qui lui est en train de dormir.
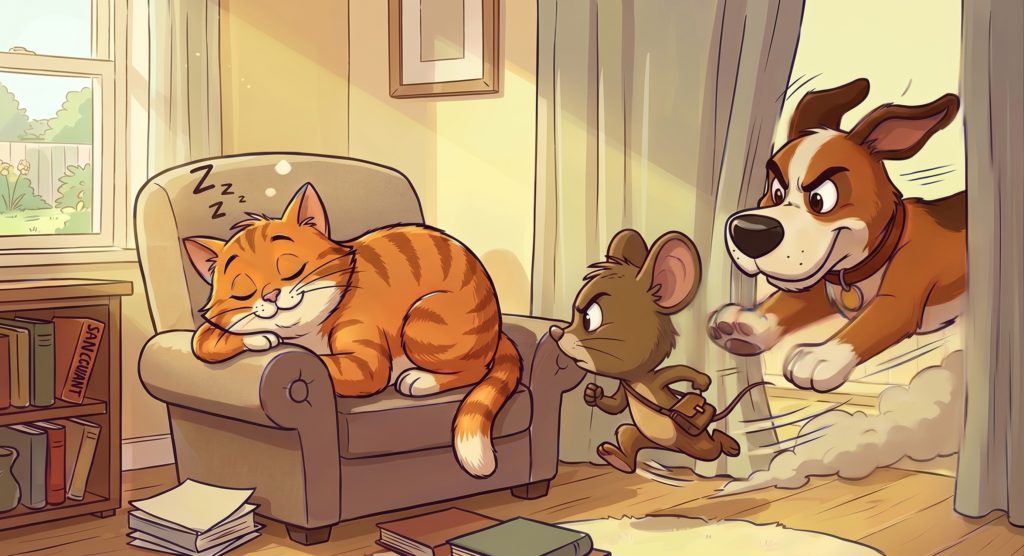 Pourquoi j’ai pris cet exemple un peu tordu ? C’est seulement pour vous faire toucher du doigt l’influence de certains mots par rapport à d’autres dans une phrase. C’est volontairement poussé à l’extrême pour que vous puissiez justement sentir cette influence et comprendre par analogie comment cette influence est déterminée en traversant des couches du modèle d’IA, comme nous avons ajouté des virgules et traversé nos propres couches de compréhension.
J’aurais également pu prendre un exemple du type : Le reflet de la statue de glace dans la glace du grenier me glaça le sang.
Ici, le mot glace apparaît plusieurs fois, mais il ne porte jamais exactement le même sens.
Chaque occurrence doit donc être interprétée différemment.
Pour un modèle de langage, cela signifie que ces mots, bien qu’identiques à l’écrit, ne peuvent pas être représentés de la même manière.
L’attention, c’est la capacité d’un modèle à relier n’importe quel mot à n’importe quel autre dans une phrase, quelle que soit la distance qui les sépare. C’est ce mécanisme qui permet au modèle de comprendre que dans ‘Le chat dort’, c’est bien le chat qui dort, et pas autre chose. Comment ? En traduisant ces relations en nombres, mais nous y reviendrons.
Ce mécanisme est au cœur de l’architecture dite des Transformers, décrite dans un papier fondateur de Vaswani et al. (2017) , celui-là même qui donne son titre à cet article.
Prenons un exemple très simple pour comprendre le mécanisme d’attention : « Le chat mange la souris ».
Comme lorsqu’à chaque étape nous avons ajouté de la ponctuation pour saisir le sens de la phrase précédente, dans un modèle de langage notre phrase traverse des couches d’attention de manière un peu similaire.
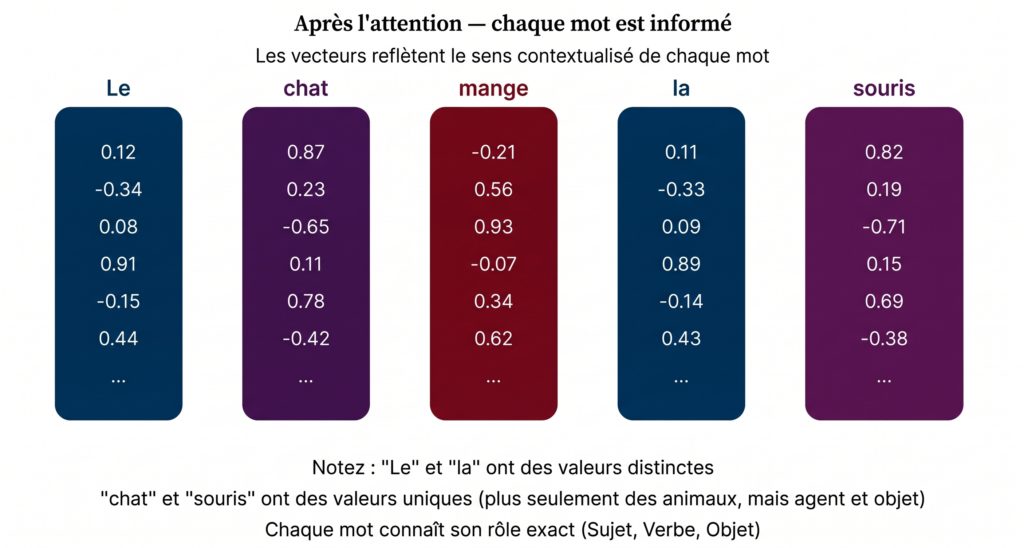
Ce qu’il faut comprendre, c’est qu’à l’entrée (au début), chaque mot est isolé. C’est juste un mot du dictionnaire, représenté comme une suite de nombres qui ne reflète que sa signification propre, hors de tout contexte, comme si chaque mot existait seul au monde.
C’est d’ailleurs ce qu’on appelle en termes techniques un vecteur d’embedding (détails dans le chapitre suivant)
1 Large Language Model (grand modèle de langage). Désigne les modèles d’intelligence artificielle entraînés sur de grandes quantités de texte, capables de comprendre et de générer du langage naturel. Les plus connus sont GPT (OpenAI), Claude (Anthropic), Gemini (Google), Mistral et Llama (Meta).
2 Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). « Attention Is All You Need. » Advances in Neural Information Processing Systems, 30 (NeurIPS 2017). https://arxiv.org/abs/1706.03762
3 Cette suite de nombres s’appelle un embedding : c’est la traduction d’un mot en un vecteur, apprise lors de l’entraînement, avec pour effet que deux mots de sens proche ont généralement des vecteurs proches car ils portent un peu de sens. « chat » et « souris » ont des vecteurs qui se ressemblent parce que ce sont des animaux
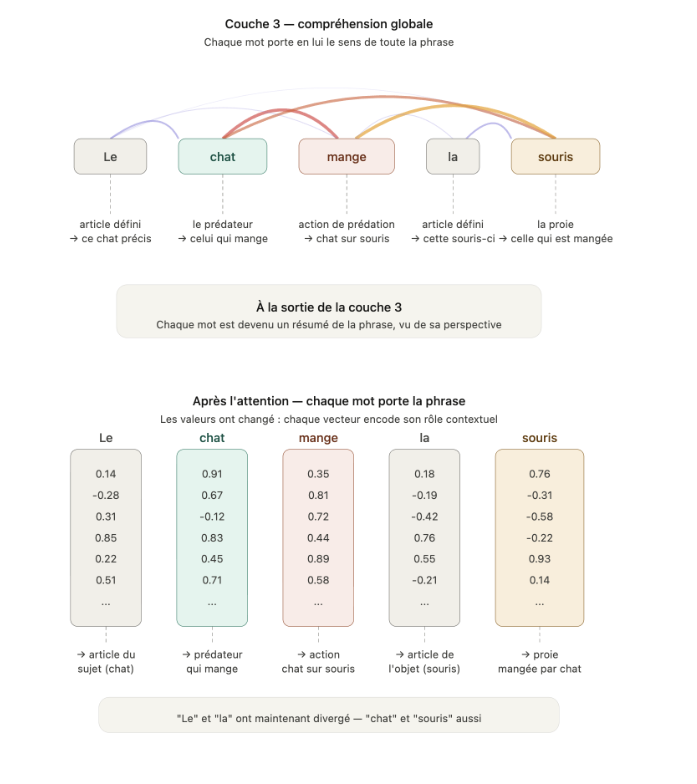
Lorsque ces mots traversent les couches d’attention (un peu comme quand nous avons ajouté des virgules et réfléchi à chaque étape au sens), les nombres qui les représentent se modifient. Chaque mot s’enrichit du contexte des autres mots qu’il a observés.
Couche après couche, ces représentations numériques s’affinent : les mots ne sont plus des entités isolées, ils deviennent les porteurs d’un sens partagé.
Un vrai modèle compte plusieurs dizaines de couches, ici, nous n’en prendrons que trois, pour l’intuition.
Observons ce qui se passe au travers de trois couches du modèle.
Couche 1 — Les associations de base. Chaque mot commence à regarder ses voisins les plus évidents. « Chat » regarde « Le » et comprend qu’on parle d’un chat spécifique, pas des chats en général. « Souris » regarde « la » de la même façon. « Mange » regarde un peu partout mais ne sait pas encore bien qui mange qui.
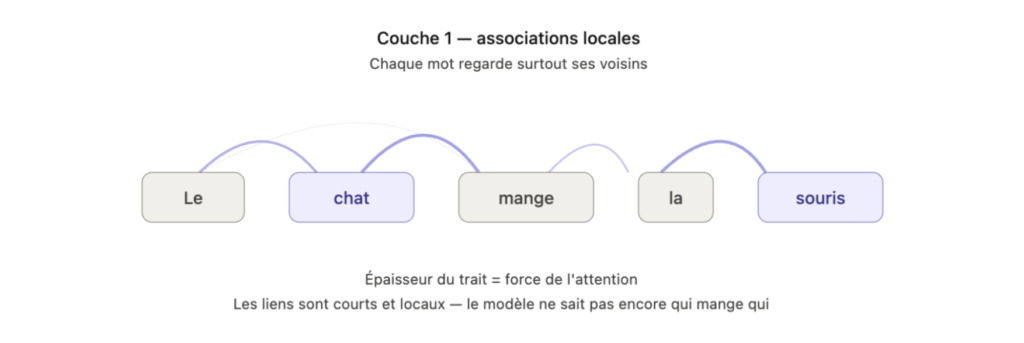
Couche 2 — Les rôles se précisent. Les relations grammaticales se forment. « Mange » se connecte fortement à « chat » (c’est lui qui mange) et à « souris » (c’est elle qui est mangée). Le modèle commence à distinguer le sujet de l’objet.
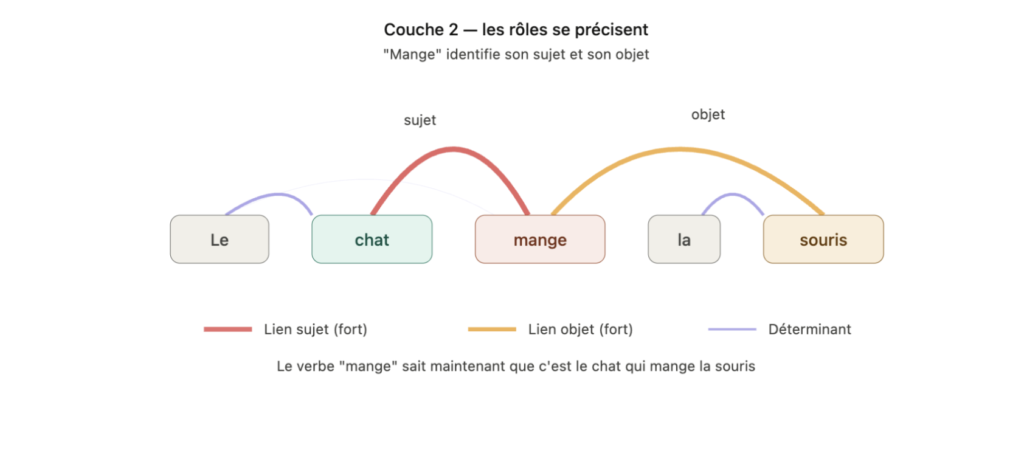
Couche 3 — La compréhension globale. Chaque mot porte maintenant en lui le sens de la phrase entière. « Chat » n’est plus juste un chat, c’est « le chat qui est en train de manger ». « Souris » n’est plus juste une souris, c’est « la souris qui se fait manger par le chat ». Même « mange » s’est enrichi : c’est « l’action d’un chat sur une souris ».
Posez la question suivante à ChatGPT, Claude ou équivalent (sur un modèle avancé de type Opus, Fable ou Astra) :
« Le chat sphinx le plus célèbre du cinéma ? »
ChatGPT me répond :
« C’est Monsieur Bigglesworth, le chat du docteur Evil dans la saga Austin Powers. »
Et en général (lorsqu’on appelle des modèles avancés de type Sonnet, Opus, Fable, Astra …) il poursuit généralement en me donnant des informations additionnelles sur ce personnage : “ Au départ, Dr. Evil avait un chat persan à poils longs, mais après leur cryogénisation, le chat perd ses poils et devient ce fameux Sphynx ”.
Cela semble assez naturel. Après tout, nous venons de poser une question et nous obtenons une réponse.
Mais si nous essayons de comprendre ce qui vient de se passer à l’intérieur du modèle, il y a plusieurs questions immédiates auxquelles on doit pouvoir répondre :
4 Dans sa réponse le LLM à même corrigé en Sphynx (chat) et même si j’avais écrit Sphinx il a compris que je ne parlais pas de monument égyptien, bien que l’orthographe était incorrect.
En réalité l’orthographe la plus répandue pour ce chat dans l’usage courant est « Sphinx » même si l’orthographe officielle est « Sphynx » : le token porte donc, dans ses statistiques d’entraînement, à la fois le sens du monument égyptien et celui du chat sans poils. C’est le contexte, ici, la proximité avec « chat », qui tranche, pas une vérification d’orthographe par rapport à une référence figée.
Nous verrons dans la seconde partie comment passer de notre question aux représentations vectorielles avant de comprendre comment les modèles s’entrainent.
D’ici là, n’hésitez pas à découvrir le programme de la formation context engineering que j’anime chez Arolla !