GenAI experience
Session à venir
12/11/2026 au 13/11/2026
Durée
2 jours

Retrouvez la premiere partie de l’article ici
Lorsque nous soumettons notre question au chatbot (notre client ChatGPT par exemple), celui-ci se contente de la transmettre au LLM, c’est-à-dire au modèle proprement dit, qu’on peut se représenter comme le « cerveau » de l’ensemble.
C’est ce dernier qui utilise un tokenizer pour transformer votre demande en une séquence de tokens, auxquels sont associées des représentations vectorielles initiales, ce qu’on appelle des embeddings, comme nous l’avons évoqué.
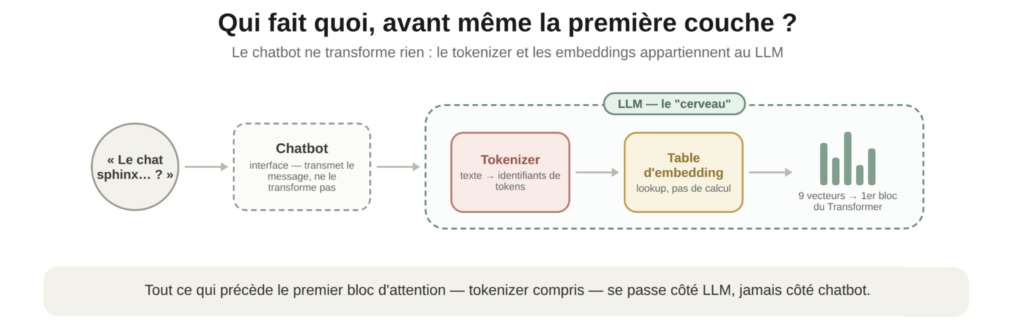
Il est très important de bien comprendre que la table d’embeddings est une immense table de correspondance figée depuis l’entraînement, avec une ligne par token possible du vocabulaire.
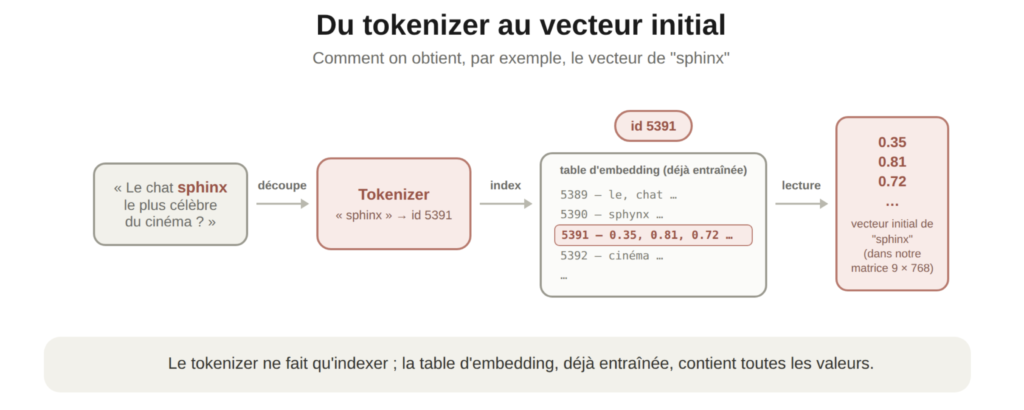
5/ Tokenizer : Le tokenizer est un algorithme séparé du réseau de neurones (il n’a pas de poids appris), mais il fait partie du LLM, pas du chatbot : chaque modèle est livré avec son propre tokenizer et son propre vocabulaire, indissociables l’un de l’autre.
6/Une table d’embedding est une immense matrice contenant une ligne par token possible du vocabulaire du modèle (plusieurs dizaines de milliers de lignes) : chaque ligne est le vecteur d’embedding de ce token. Elle fait partie des poids du modèle et a été apprise une fois pour toutes pendant l’entraînement ; à l’usage, on ne fait qu’y piocher les lignes correspondant aux tokens de la phrase, sans aucun calcul
Il faut donc bien comprendre que tous les « ? » de toutes les questions du monde, posées par n’importe qui, à n’importe quel moment, pointent vers exactement le même identifiant, donc récupèrent exactement la même ligne dans la table, donc partent avec un vecteur strictement identique, bit pour bit.
Ce vecteur d’embedding initial représente donc une sorte “d’encodage” de votre “question” ou “phrase”, ou “bloc de code” dans une forme numérique matricielle portant un sens de base que le LLM comprend car c’est lui même qui a encodé ces concepts dans la table d’embeddings sous leur forme de base.
Le modèle va donc partir de cette représentation initiale de la phrase et enrichir cette représentation en exploitant les relations entre les différents éléments de notre question :
Mais pour exploiter les relations entre les différents éléments de notre question il va justement faire appel à l’ensemble du réseau de neurones, qui à travers ses paramètres appris et ses différentes opérations mathématiques, va transformer progressivement les représentations numériques en traversant les blocs ou couches du Transformer.
Continuons cette plongée dans le LLM à l’aide de notre exemple …
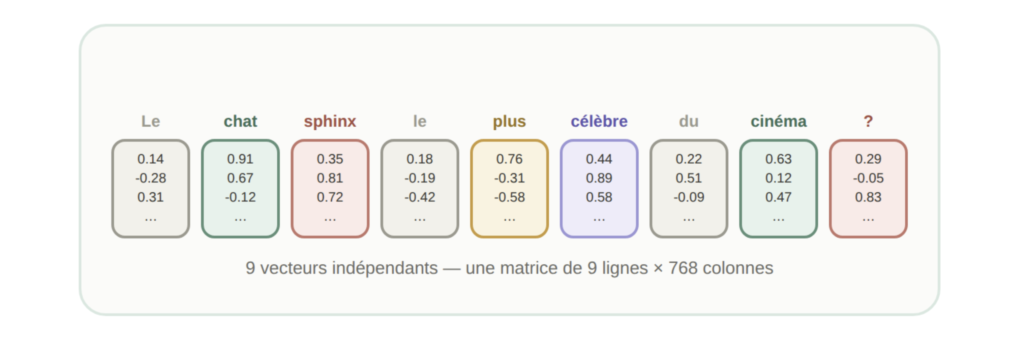
Imaginons donc, pour simplifier, que notre question ait été découpée en neuf tokens (le point d’interrogation étant aussi 1 Token) et que notre modèle utilise des vecteurs de 768 dimensions.
Notre question représente désormais un groupe de 9 vecteurs (pour simplifier nous associons un vecteur à un mot complet ou un symbole) dont le sens “général” de chaque token est compris par le LLM.
Ces neuf vecteurs initiaux de 768 coordonnées sont rassemblés dans une matrice de neuf lignes et 768 colonnes.
Lorsque cette matrice traverse un bloc du Transformer, celui-ci produit neuf nouvelles représentations vectorielles, toujours de 768 dimensions et ainsi de suite, jusqu’à la dernière couche.
Dans un LLM génératif de type GPT, le mécanisme d’attention est dit causal : chaque position peut exploiter les informations provenant des positions précédentes et d’elle-même, mais pas des positions suivantes.
La représentation de la dernière position peut donc intégrer des informations provenant de l’ensemble de notre question.
C’est cette représentation que le modèle va utiliser pour calculer les scores des prochains tokens possibles.
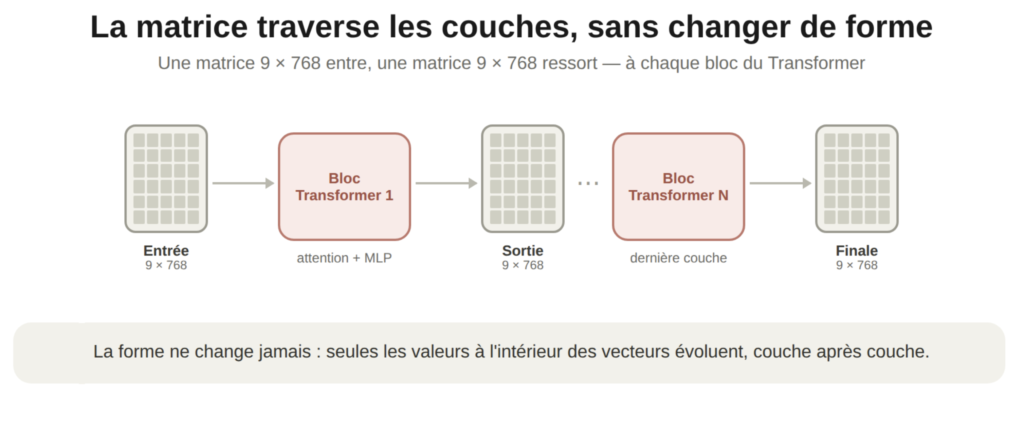
7/ En machine learning une matrice de forme [longueur de séquence, dimension] s’écrit [9, 768], soit 9 lignes, une par token, et 768 colonnes, une par dimension du vecteur
Notre phrase « Le chat sphinx le plus célèbre du cinéma ? » est donc devenue neuf vecteurs, un par token, rassemblés dans une matrice.
Cette matrice va maintenant traverser plusieurs dizaines de blocs du Transformer, les uns après les autres. Mais concrètement, que se passe-t-il à l’intérieur d’un bloc ?
En fait, à l’intérieur d’un bloc, chaque vecteur traverse deux étapes successives :
Un détail compte particulièrement : à chaque étape, le vecteur n’est jamais remplacé, il est complété. Ce que produisent l’attention et le MLP s’additionne au vecteur d’entrée, plutôt que de l’écraser.
Chaque mot conserve en quelque sorte un carnet qui s’enrichit de nouvelles annotations à chaque couche, sans jamais effacer les précédentes, c’est ce qui permet à l’information de s’accumuler tout au long du réseau, jusqu’à la dernière couche.
8/MLP (Multi-Layer Perceptron, ou « feed-forward ») : le second réseau de chaque bloc, appliqué indépendamment à chaque position. Contrairement à l’attention, il ne fait pas interagir les mots entre eux, il affine chaque vecteur pris isolément.
9/addition vectorielle : le résultat reste une matrice de mêmes dimensions, les nouvelles annotations qui enrichissent le sens sont intégrées au sein même des nombres eux-mêmes
Concrètement, dans notre exemple, voici ce qu’on peut raisonnablement penser qu’il se passe (avec une prudence nécessaire : personne n’a « regardé à l’intérieur » de ce modèle précis pour cette question précise, mais des travaux de recherche en interprétabilité ont observé ce schéma sur d’autres modèles et d’autres questions similaires, bien que beaucoup plus simplistes).
Dans les premières couches, le vecteur du mot « sphinx » s’enrichit du contexte immédiat : « chat » (donc il ne s’agit pas du monument égyptien), puis « célèbre », puis « cinéma ». Au fil des couches, ce vecteur ne représente donc plus seulement le mot « sphinx » isolé, mais quelque chose comme « on cherche un chat de race sphynx connu dans un film ».
Dans les couches plus profondes, cette représentation, désormais assez précise pour désigner un sujet presque unique car il n’y a pas des dizaines de chats sphynx célèbres au cinéma, vient rencontrer les poids du modèle. Ces poids qui ont été justement façonnés pendant l’entraînement par des milliers de textes qui associaient justement « chat sans poils » à « Dr. Evil », « Austin Powers », « Monsieur Bigglesworth ».
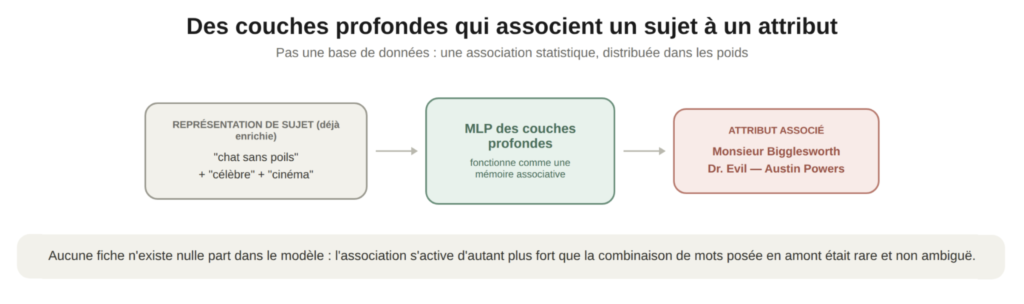
Des chercheurs qui ont étudié ce type de mécanisme (notamment sur la localisation des faits appris par GPT) ont montré que ce sont surtout les MLP de ces couches profondes qui semblent fonctionner comme une mémoire associative : ils prennent une représentation de sujet bien identifiée et lui associent une représentation d’attribut, un peu comme si le réseau retrouvait « la bonne fiche » à partir d’une description suffisamment précise du sujet.
Ce n’est en aucun cas une recherche dans une base de données : il n’existe nulle part dans le modèle une fiche « Monsieur Bigglesworth : chat, race sphynx, propriétaire Dr. Evil ». Il s’agit d’une association statistique, distribuée dans des milliards de poids, qui s’active d’autant plus fort que la combinaison de mots posée en amont était rare et non ambiguë.
C’est ce qui explique pourquoi la réponse est aussi précise sur cette question : la combinaison « chat », « sphynx », « célèbre », « cinéma » pointe presque électriquement vers une seule zone de ce que le modèle a appris. Et pourquoi, à l’inverse, sur une question plus rare ou plus ambiguë, la même mécanique peut produire une réponse plausible mais fausse : une hallucination.
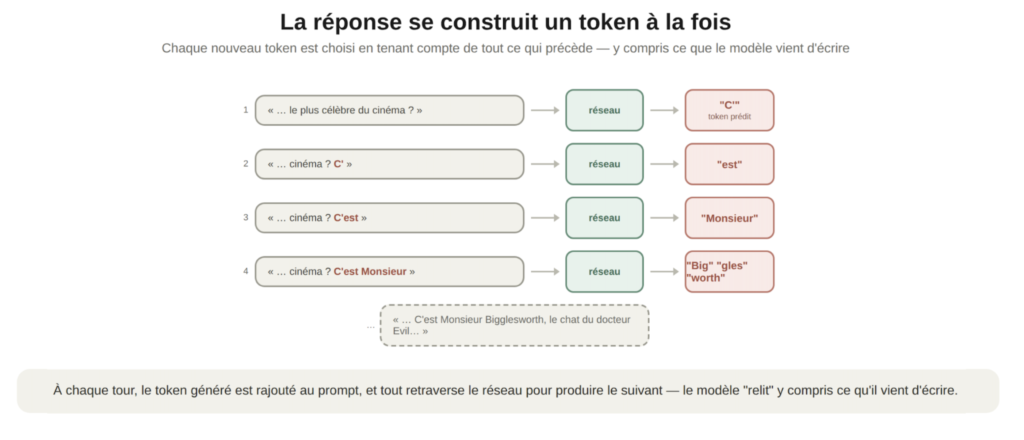
Une fois que la dernière position de notre question porte cette représentation suffisamment riche, elle est utilisée, comme on l’a vu, pour calculer les scores du prochain token.
Le modèle ne génère pas la phrase de réponse d’un coup : il produit un premier token (« C' »), qui vient s’ajouter à la suite du prompt, puis tout retraverse le réseau pour produire le suivant (« est »), puis « Monsieur », puis les morceaux de « Bigglesworth », et ainsi de suite, chaque nouveau mot étant choisi en tenant compte de tout ce qui précède, y compris ce que le modèle vient tout juste d’écrire lui-même.
Le même mécanisme explique la suite de la réponse, quand le modèle ajoute que Dr. Evil avait au départ un chat persan à poils longs, devenu sphynx après la cryogénisation : ce n’est pas une déduction logique tirée du scénario, c’est un motif textuel, ce détail précis de l’intrigue, suffisamment répété dans les résumés du film et les fiches de personnages que le modèle a lus pendant son entraînement pour qu’il soit rattaché, dans ses poids, au sujet « Monsieur Bigglesworth ».
Reste une chose honnête à assumer : ce récit décrit bien le mécanisme général, et s’appuie sur des travaux de recherche réels, mais il ne constitue pas une preuve, circuit par circuit, de ce qui s’est passé dans ce modèle précis pour cette question précise. Une traçabilité aussi complète n’existe aujourd’hui que pour des cas beaucoup plus simples, étudiés en laboratoire.
Ce qui se passe exactement dans les couches d’un grand modèle de langage sur une question de culture générale reste, pour une part, un objet de recherche actif et complexe.
Et ces deux opérations, l’attention et le petit réseau qui suit, ne sont pas des règles écrites à la main : ce sont des calculs, essentiellement des multiplications de matrices, dont les paramètres ont été fixés par l’entraînement.
Ce mécanisme d’attention que nous venons de décrire, ne se déclenche pas uniquement quand vous posez une question à un chatbot. Il est d’abord au cœur de l’entraînement du modèle.
Pendant des semaines, sur des milliers de machines, le modèle a lu des milliards de textes. Pour chaque phrase, il a déroulé ce même processus : les mots se regardent, les connexions se forment, les vecteurs s’enrichissent, un peu comme dans nos schémas.
Mais à l’entraînement, il y a une étape supplémentaire : le modèle compare ce qu’il a compris avec ce qu’il aurait dû comprendre, et il ajuste ses paramètres en conséquence. Petit à petit, couche après couche, phrase après phrase, ces ajustements s’accumulent et se cristallisent en ce qu’on appelle les poids du modèle.
Ces poids, ce sont des nombres. Beaucoup de nombres.
GPT-3 en compte 175 milliards. GPT-4, probablement plus d’un trillion. Pour donner un ordre de grandeur : si vous écriviez un poids par seconde, sans dormir, sans pause, il vous faudrait plus de 5 000 ans pour noter ceux de GPT-3.
Stockés sur disque, les poids d’un seul modèle représentent plusieurs centaines de gigaoctets, l’équivalent de dizaines de milliers de films en texte brut, compressés dans une matrice de nombres. Et chacun de ces nombres, pris individuellement, ne veut rien dire. C’est leur agencement collectif, la façon dont ils interagissent entre eux à travers les couches, qui encode tout ce que le modèle a « compris ».
C’est là que réside tout ce que le modèle a appris : pas des phrases mémorisées, mais des régularités, des structures, une forme de compréhension implicite du langage. Ce sont eux qui permettent ensuite au modèle, quand vous lui soumettez un prompt, de réutiliser le mécanisme d’attention avec compétence, de comprendre votre phrase et de générer une réponse cohérente, mot après mot.
C’est d’ailleurs pour cela que les poids sont le trésor le plus précieux des entreprises qui développent ces modèles. L’architecture des Transformers est publique, le mécanisme d’attention est décrit dans un papier accessible à tous. Mais les poids, eux, sont le résultat de mois d’entraînement sur des données massives, avec des ressources de calcul colossales dont le coût se chiffre en dizaines, voire en centaines de millions de dollars.
Ils sont ce qui distingue un modèle performant d’une coquille vide.
Les mots dans l’espace et la généralisation
Nous avons vu que les mots de notre phrase étaient représentés par des suites de nombres qui évoluent au fil des couches du modèle. Mais d’où viennent ces nombres ? Et que représentent-ils exactement ?
Commençons par une précision : un LLM ne manipule pas directement des mots, mais des tokens. Un tokenizer découpe le texte en unités qui peuvent correspondre à un mot entier, à une partie de mot, à un signe de ponctuation, etc. Chaque token reçoit un identifiant entier, le token ID. Ce nombre n’est pas, à lui seul, une représentation du sens : il permet de retrouver une ligne dans une table de nombres apprise pendant l’entraînement.
Nous avons vu que chaque mot est représenté par une suite de nombres, un vecteur. Mais ces nombres ne sont pas arbitraires. Pendant l’entraînement, le modèle organise ses vecteurs dans un espace mathématique à plusieurs milliers de dimensions.
C’est difficile à visualiser, alors ramenons ça à trois dimensions.
Imaginons un espace vectoriel à 3 dimensions. Dans cet espace, chaque mot occupe une position. Et les mots qui ont des sens proches se retrouvent proches dans cet espace vectoriel: « chat » est près de « chien », « roi » est près de « reine », « Paris » est près de « Berlin ».
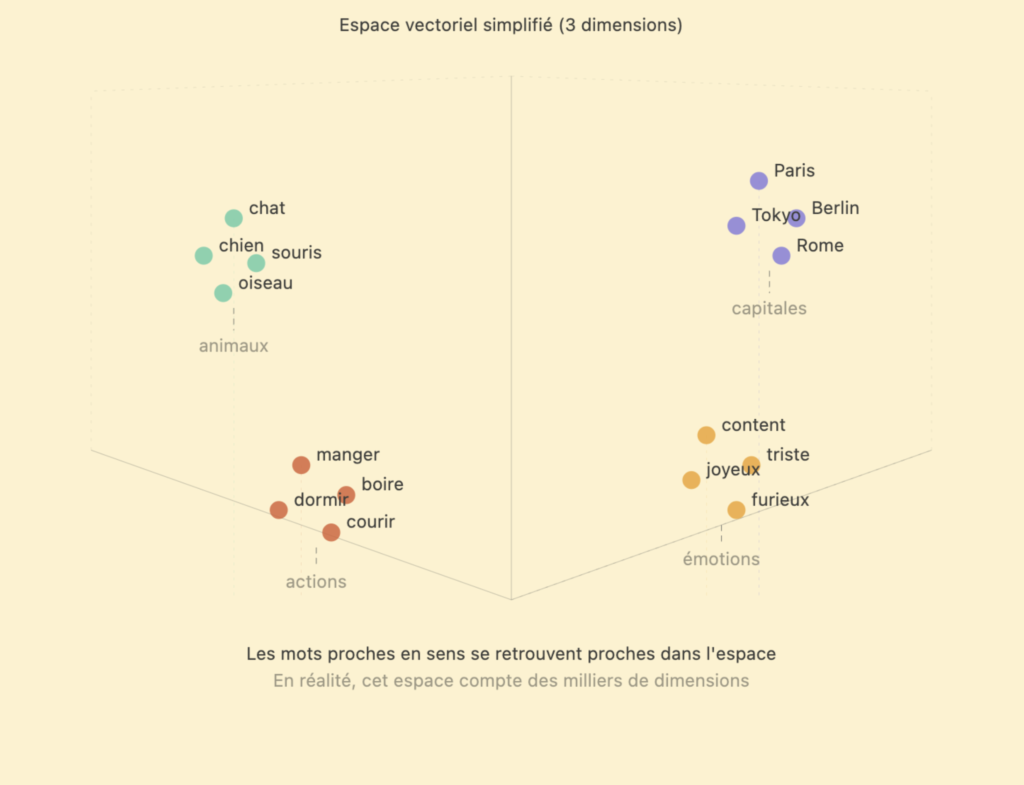
Mais le plus surprenant, ce n’est pas que les mots proches soient regroupés. C’est que les directions dans cet espace ont un sens.
Prenons un exemple célèbre. Si on prend le vecteur du mot « roi », qu’on lui soustrait le vecteur de « homme », et qu’on ajoute celui de « femme », on obtient un vecteur très proche de… « reine ». Autrement dit :
roi − homme + femme ≈ reine
Ce n’est pas une métaphore. C’est une opération arithmétique réelle, effectuée sur les nombres qui représentent ces mots. Le modèle a découvert, tout seul, que la relation « masculin → féminin » peut s’exprimer comme une direction dans l’espace.
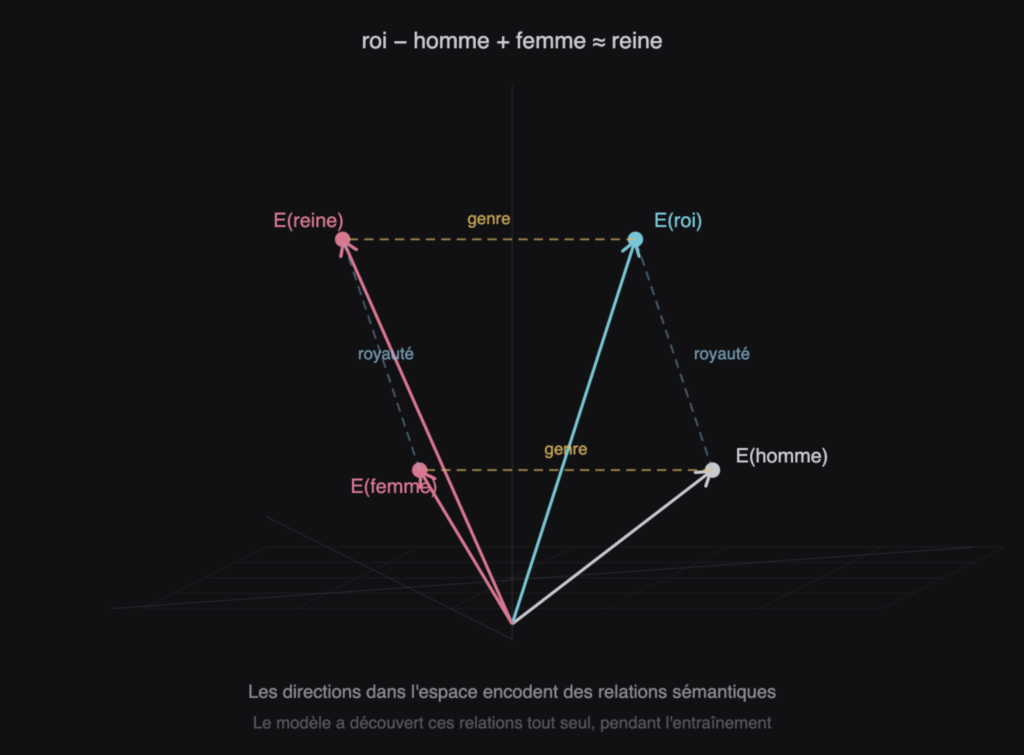
C’est cette géométrie qui donne au modèle sa puissance. Les concepts ne sont pas stockés dans une table, ils sont encodés dans la structure même de l’espace. Et cet espace ne se limite pas à des relations simples comme le genre : on y retrouve des directions pour le temps (présent → passé), la géographie (pays → capitale), et bien d’autres relations que le modèle a extraites de ses données d’entraînement.
Le modèle est alors en mesure de généraliser .
Si on lui pose la question “La reine est au roi ce que la femme est à ?”, il répondra, “l’homme”. Et il saura identifier par une direction similaire oncle/tante, neveu/niece, père/mère.
10/Capacité d’un modèle d’apprentissage automatique à produire des prédictions correctes sur des données qu’il n’a jamais vues, en capturant des régularités ou des structures sous-jacentes plutôt qu’en se contentant de mémoriser les exemples d’entraînement. Pour des informations plus approfondies sur la généralisation dans l’apprentissage automatique, vous pouvez vous référer à des manuels comme « Deep Learning » (https://www.deeplearningbook.org/) d’I. Goodfellow et Y. Bengio.
Non pas parce qu’il a mémorisé ces associations, mais parce qu’il a capturé, dans la géométrie de son espace vectoriel, la structure abstraite de la relation entre ces mots.
C’est cette capacité à manipuler des directions dans l’espace qui lui permet de raisonner par analogie sur des cas qu’il n’a jamais rencontrés tels quels.
C’est aussi pour cette raison que les vecteurs n’ont pas 3 dimensions dans les modèles, mais un très grand nombre de dimensions (12 288 pour GPT-3) car les directions dans l’espace représentent des concepts (du sens) encodés par ces vecteurs.
C’est ainsi que fonctionne, en substance, la “magie” de nos LLM. Pas de véritable magie bien sûr, mais une mécanique élégante où des vecteurs, des couches d’attention et des milliards de poids s’articulent pour produire quelque chose qui ressemble étrangement à de la compréhension.
Quant à toi courageux lecteur tout d’abord je te félicite d’être arrivé jusqu’ici et je te donne rendez vous pour un prochain article où nous aborderons par la suite des sujets plus concrets dans notre travail de développeur comme le prompt engineering, les agents autonomes ou encore le MCP, autant de concepts qui transforment déjà concrètement notre façon de développer.