Working on legacy code
Session à venir
08/10/2026 au 09/10/2026
Durée
2 jours

Dans l’imaginaire collectif du développement logiciel, la performance est souvent associée à l’optimisation des algorithmes ou à la puissance du matériel. Pourtant, dans la réalité des systèmes d’entreprise, l’un des principaux goulots d’étranglement est l’accès à la donnée.
Un moteur de base de données n’est pas un simple réservoir passif, c’est un organisme vivant qui impacte la réactivité de l’ensemble du système. Un logiciel peut être conçu avec des patterns élégants et un code propre. Mais si chaque requête utilisateur déclenche un « Full Table Scan » sur des millions de lignes, l’expérience utilisateur s’effondre.
La performance d’un logiciel est directement corrélée à la manière dont il interagit avec son stockage. Deux facteurs dominent cette dynamique :
Les index sont des structures de données qui organisent et trient les informations pour accélérer considérablement leur récupération. Ils fonctionnent de manière similaire à l’index d’un livre, permettant de localiser rapidement des lignes spécifiques sans avoir à parcourir toute la table. Il existe une multitude de types d’index, chacun utilise un algorithme différent pour répondre à une problématique spécifique de recherche. Donc, chaque type d’index dépend des colonnes manipulées et des patterns de requêtes effectuées. Dans les bases de données relationnelles (MySQL, PostgreSQL, Oracle et/ou SQL Server), les principaux types d’index sont les suivants :
Le B-Tree (Balanced Tree) est l’index par défaut de la quasi-totalité des bases de données relationnelles.
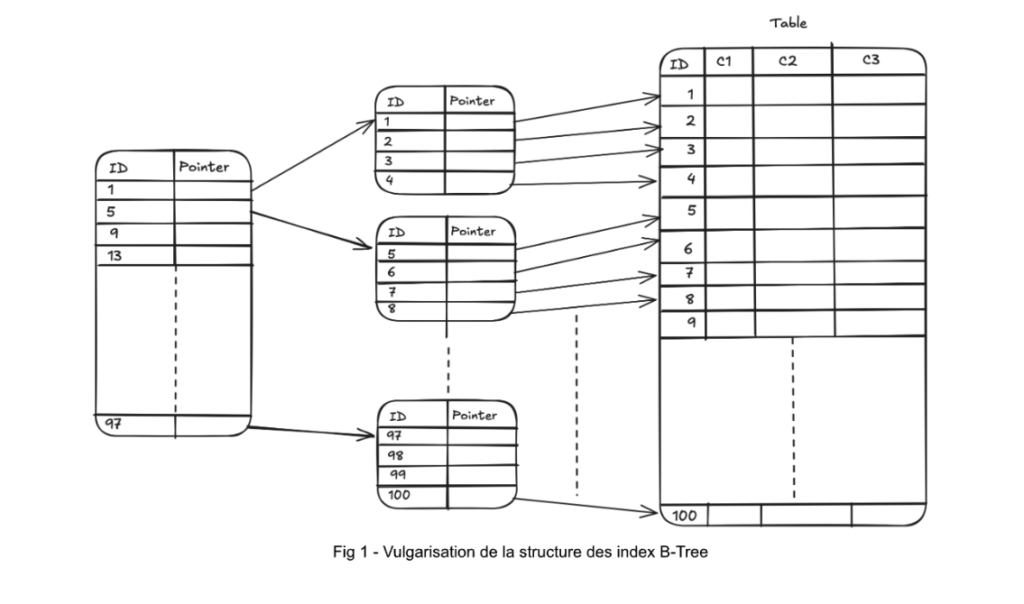
Avant tout, nous avons d’abord besoin d’une table :
CREATE TABLE customers
(
    id uuid NOT NULL,
    first_name character varying(32) NOT NULL,
    last_name character varying(64) NOT NULL,
    birth_date date,
    address text,
    email character varying(255) NOT NULL,
    created_at date NOT NULL,
    last_updated_at date,
    CONSTRAINT customers_pkey PRIMARY KEY (id)
);
Ensuite, on va y stocker un grand volume de données pour tester l’efficacité des index :
WITH GEN AS (
    SELECT generate_series(1,10e6) n
)
INSERT INTO customers(id, first_name, last_name, birth_date, address, email, created_at)
SELECT
    gen_random_uuid() id,
    CONCAT('firstName', n)::varchar first_name,
    CONCAT('lastName', n)::varchar last_name,
    CURRENT_DATE - (random()*365)::integer birth_date,
    CONCAT(n,' RUE', SUBSTR(MD5(RANDOM()::TEXT), 1,10)) address,
    CONCAT('firstName', n, '.', 'lastName', n, '@domain.fr')::varchar email,
    CURRENT_DATE AS created_at
FROM GEN;
Le dernier script permet de générer et enregistrer 10 millions de lignes dans la table « customers » créée précédemment. Pour créer des tests automatisés et répétables, nous avons choisi d’utiliser « JMeter » avec une connexion via JDBC à la base de données PostgreSQL.
Pour le premier test, nous allons faire une recherche d’égalité :
SELECT * FROM customers WHERE address = '6 RUE 893611392d';
En lançant cette requête depuis JMeter on obtient le résultat suivant :
Load time: 2804
Connect Time: 200
Latency: 2799
À quoi correspondent ces chiffres ?
D’abord Connect, il représente le nombre de millisecondes que JMeter a mis à se connecter au serveur de base de données. Ce chiffre n’est pas impacté par les index puisqu’il est lié au réseau, l’authentification (handshake, etc…), logs serveur, etc.
Latency et Load time correspondent respectivement au temps passé à récupérer le premier et le dernier Byte de la réponse. On va s’intéresser uniquement à la différence entre ces 2 derniers (Load time – Latency) pour déduire le temps nécessaire à la réception de la réponse complète.
Ajoutons maintenant l’index B-Tree sur la colonne address :
CREATE INDEX idx_customers_address ON customers (address);
Le résultat avec index devient :
Load time: 74
Connect Time: 71
Latency: 74
On peut constater alors que l’index nous a permis de passer de 5 ms à moins de 1 ms.
Pour le deuxième test, nous cherchons une plage de valeurs :
SELECT * FROM customers WHERE birth_date < '2026-04-13';
Sans index on obtient ce résultat :
Load time: 62764
Connect Time: 327
Latency: 14407
On ajoute un autre index sur la colonne birth_date :
CREATE INDEX idx_customers_birth_date ON customers (birth_date);
Le résultat après création d’index est le suivant :
Load time: 30544
Connect Time: 194
Latency: 7201
On peut voir alors qu’on est passé de 48 357 ms à 23 343 ms.
Moins commun mais extrêmement puissant, il transforme la valeur recherchée en une empreinte unique via une fonction de hachage.
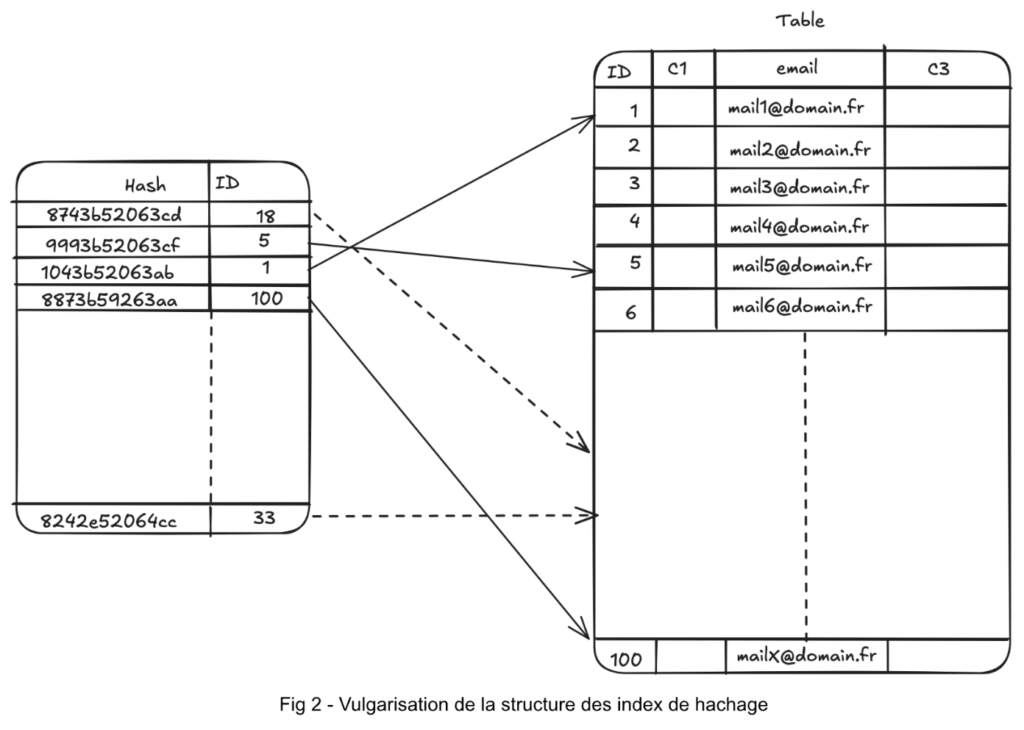
Nous allons maintenant faire une recherche d’égalité sur la colonne « email » :
SELECT * FROM customers WHERE email = 'firstName22.lastName22@domain.fr';
Le résultat de la requête exécutée depuis JMeter est le suivant :
Load time: 3911
Connect Time: 397
Latency: 3903
Maintenant on crée l’index Hash sur la colonne « email » :
CREATE INDEX idx_customers_email ON customers USING HASH (email);
Voici le résultat obtenu :
Load time: 89
Connect Time: 85
Latency: 89
On constate alors que la requête avec index met moins de 1 ms pour retourner le résultat contre 8 ms sans index.
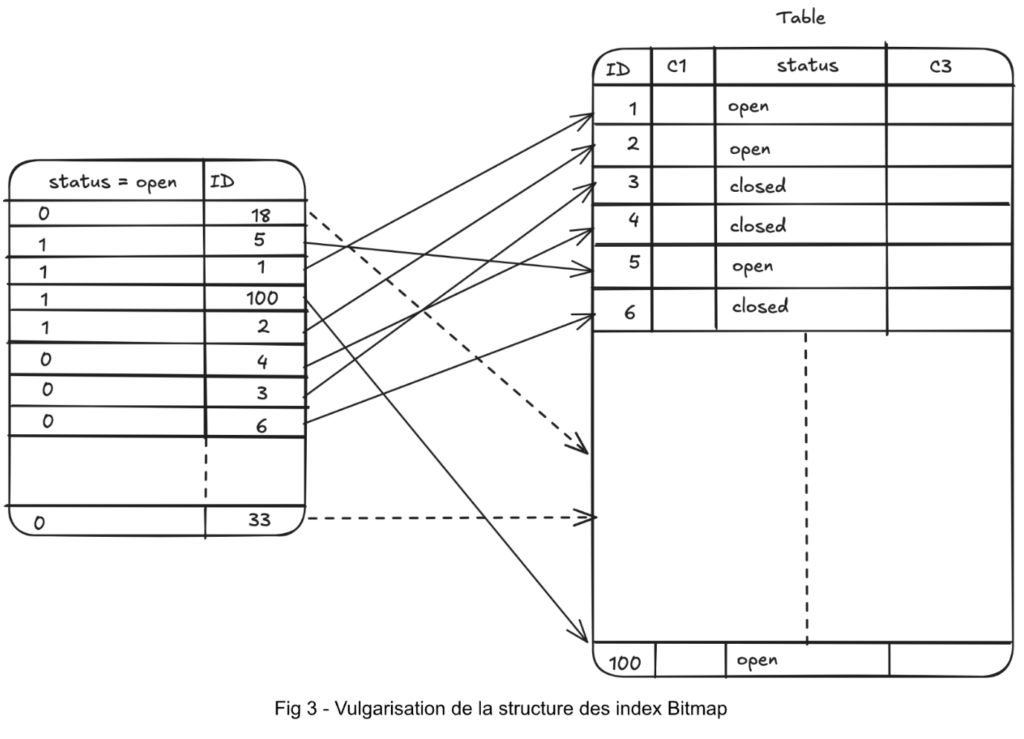
Si le B-Tree aime la diversité, l’index Bitmap préfère la répétition.
Generalized Inverted Index, il s’agit d’un index inversé qui liste chaque mot et pointe vers toutes les lignes qui le contiennent.
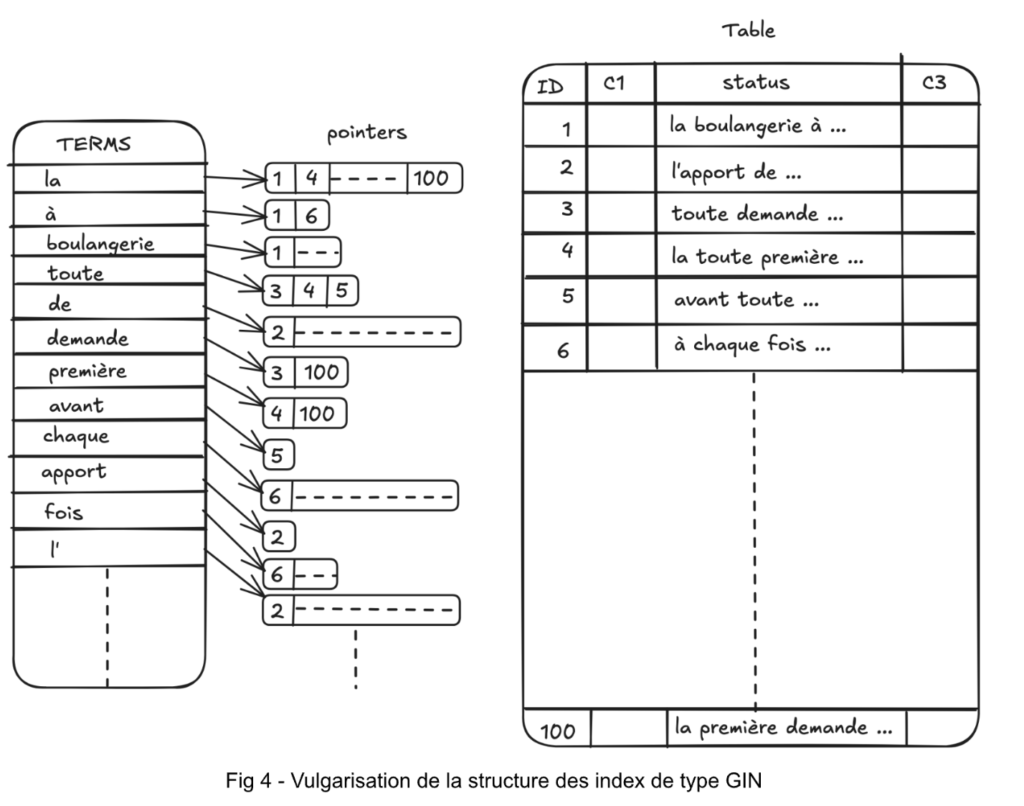
Bien que les index accélèrent les lectures, ils présentent deux inconvénients majeurs : ils consomment de l’espace de stockage supplémentaire et ralentissent les écritures (INSERT, UPDATE, DELETE), car chaque index doit être mis à jour lors de la modification des données. De plus, au fil du temps, les opérations fréquentes de suppression (DELETE) et de mise à jour (UPDATE) entraînent une dégradation progressive des performances en générant une fragmentation interne de l’index, ce qui nécessite des opérations régulières de maintenance et de réindexation. La stratégie optimale consiste à indexer uniquement les colonnes fréquemment utilisées dans les clauses WHERE, JOIN et/ou ORDER BY.
Nous allons maintenant analyser l’impact des index créés précédemment sur la consommation de l’espace disque.
SELECT pg_size_pretty(pg_relation_size('customers'));
La table « customers » avec 10 millions de lignes a une taille de 1052 MB. Pour voir la taille occupée par les index liés à cette table on exécute la requête suivante :
SELECT pg_size_pretty(pg_indexes_size('customers'));
Initialement et sans créer d’index, le résultat est de 386 MB. Il s’agit de la taille des clés primaires qui est par défaut un index B-Tree dans PostgreSQL.
À chaque fois qu’on crée un index, on réexécute la même requête pour calculer l’espace supplémentaire alloué. Voici les mesures :
On remarque que 2 index du même type sur la même table ont des tailles différentes, ceci s’explique par la taille des colonnes indexées. Dans notre exemple :
Ces mesures montrent que les index ont un coût en espace de stockage. Ce coût dépend du nombre de lignes d’une table, mais aussi de la taille mémoire de la colonne à indexer. Voyons maintenant comment les index sont stockés en mémoire.
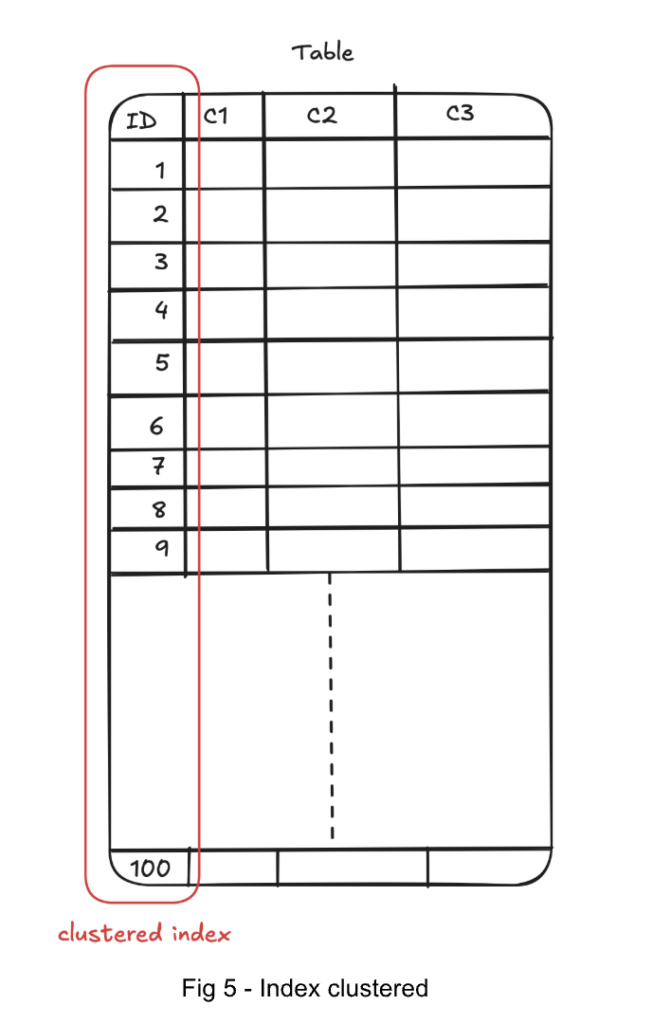
L’index clustered définit l’ordre physique dans lequel les données sont stockées sur le disque au sein de la table. L’implémentation de cet index varie en fonction du moteur de base de données. Dans SQL Server par exemple, puisque les lignes ne peuvent être rangées physiquement que d’une seule manière, il ne peut exister qu’un seul index clustered par table. Et la clé primaire est souvent configurée comme index clustered par défaut.
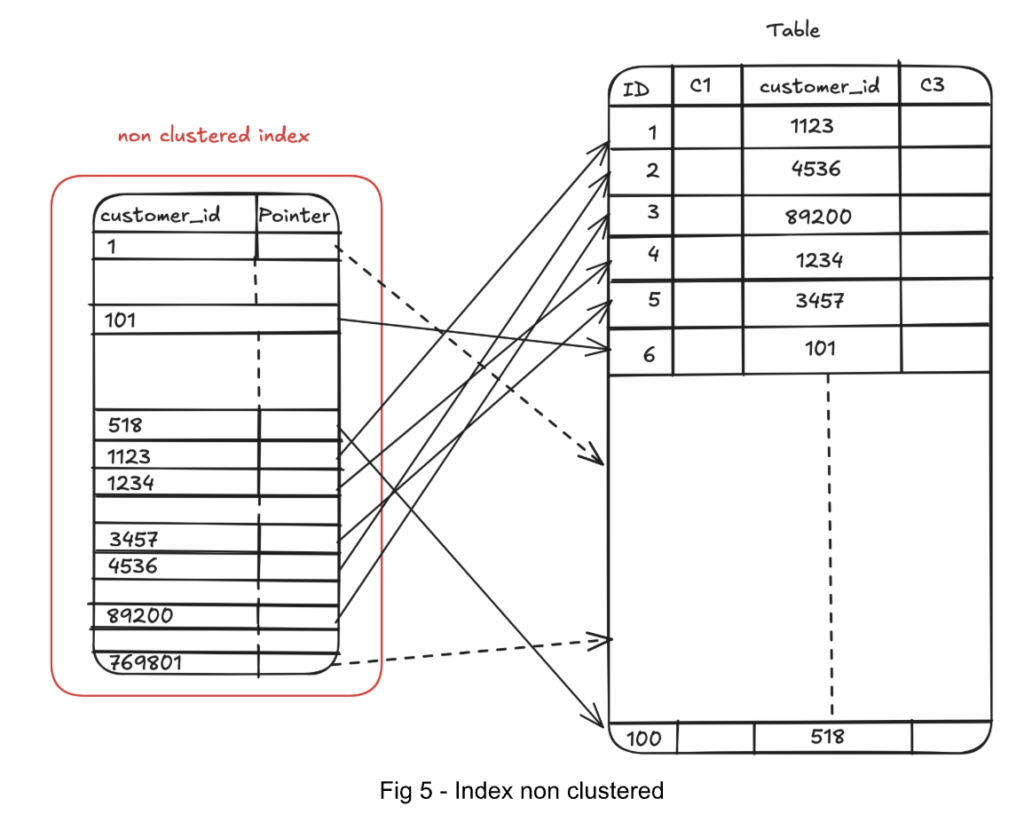
Un index non-clustered est une structure séparée de la table qui contient une copie triée de certaines colonnes ainsi que des pointeurs vers les données réelles de la table. Contrairement à l’index clustered, on peut en créer plusieurs pour cibler différentes colonnes afin d’optimiser différentes recherches.
Parfois, un index standard ne suffit pas à capturer la subtilité d’une règle métier. Pour optimiser réellement les performances, on dispose de techniques chirurgicales. Voici une liste non exhaustive.
Un index partiel est construit sur un sous-ensemble des lignes d’une table, défini par une condition de filtrage. Cela permet de réduire la taille de l’index sur le disque et d’accélérer les performances pour des requêtes très spécifiques.
WHERE status = 'OPEN' rendra ces requêtes plus rapides tout en économisant de l’espace.C’est l’art de combiner plusieurs champs dans une seule structure.
WHERE pays = 'FR' AND statut = 'VALIDE').SELECT B FROM table WHERE A = 1, le SGBD ne va même pas lire la table. Il répond directement depuis l’index.Exemple concret : Imaginons une table Tickets avec des millions de lignes. La règle métier est : L’utilisateur veut afficher l’historique des tickets d’un client spécifique, triées par date, pour voir les plus récentes en premier.
La requête SQL :
SELECT id, status, date_creation
FROM Tickets
WHERE client_id = 452
ORDER BY date_creation DESC;
L’index optimal :
CREATE INDEX idx_client_date ON Tickets (client_id, date_creation DESC);
Pourquoi cet ordre :
L’index de couverture permet d’aller encore plus loin que l’index composite. Au lieu d’ajouter une colonne dans la structure de tri de l’arbre (ce qui coûte cher), on « transporte » simplement la donnée supplémentaire dans les feuilles de l’index avec le mot clé INCLUDE.
L’index de couverture et l’architecture CQRS : C’est l’arme absolue pour le Read Model. Si la vue a besoin du nom et du téléphone à partir d’un id_client, on crée un index sur id_client qui inclut les deux autres champs. La requête devient « Index Only Scan » : le SGBD ne va pas jusqu’à la table principale car toutes les données nécessaires sont stockées dans l’index.
Par défaut, un index classique ne connaît que la valeur stockée. Si on transforme cette valeur dans la clause WHERE (ex: mise en minuscule, calcul, extraction de date…), l’index standard devient inutile. L’index d’expression résout ce problème en pré-calculant le résultat de la fonction et en le stockant dans l’arbre de l’index.
WHERE LOWER(email) = '...', un index standard sur email ne sera pas utilisé par le SGBD. On doit alors créer un index sur l’expression :
CREATE INDEX idx_user_email_lower ON users (LOWER(email));
Selon les principes du Software Craftsmanship, la structure du code doit s’aligner sur le domaine métier. Le choix d’un index n’est pas qu’une optimisation technique, c’est une décision de conception. Mais, il s’agit ici de conception émergente (emergent design), l’idée est d’éviter la sur-optimisation prématurée. On ajoute un index parce qu’un test de performance (ou un besoin utilisateur) le justifie. Ces techniques permettent d’appliquer les principes « YAGNI » et « KISS » : on n’indexe pas tout, on indexe intelligemment ce qui apporte de la valeur au comportement (Behavior) de l’application en observant les « Query Patterns ».
De plus, l’index et son nommage doivent explicitement documenter l’intention métier.
La propreté du code s’étend à la structure de la base de données. Un index qui n’est plus utilisé n’est pas seulement « inutile », c’est une dette technique active.
Chaque index ajouté a un prix caché et est donc à surveiller :
On ne peut pas améliorer ce qu’on ne mesure pas. L’analyse des plans d’exécution (via EXPLAIN ou EXPLAIN ANALYZE) permet de diagnostiquer les requêtes lentes et tester l’utilisation d’un index. En complément, on peut suivre les statistiques globales de la base de données pour :
pg_stat_user_indexes, SQL Server avec les DMV) permettent de savoir exactement combien de fois un index a été sollicité depuis le dernier redémarrage.Tout comme on refactore une classe trop complexe, on doit refactorer ses index :
WHERE active = true) pour gagner en espace et en performance.Considérer la base de données comme un simple détail d’implémentation est une erreur de conception majeure. Mis à part le choix des structures de données adaptées au besoin, deux points sont fondamentaux :
Cependant, posséder une boîte à outils perfectionnée ne garantit pas la construction de solutions robustes. Un index, aussi performant soit-il, n’a de valeur que s’il sert un besoin utilisateur réel et s’il est maintenable sur le long terme. Créer un index complexe « au cas où » est la première étape vers une dette technique regrettable.
Session à venir
08/10/2026 au 09/10/2026
Durée
2 jours
Session à venir
09/11/2026 au 10/11/2026
Durée
2 jours
Session à venir
12/10/2026 au 13/10/2026
Durée
2 jours
03/11/2023
04/03/2026
12/08/2024